O MiniMax H3 é um modelo de inteligência artificial que gera vídeos com áudio nativo a partir de variados formatos de entrada. Com 33 bilhões de parâmetros, o sistema suporta resoluções até 2K. O conteúdo detalha uma refatoração do workflow oficial do ComfyUI para expandir funcionalidades e o controle técnico.
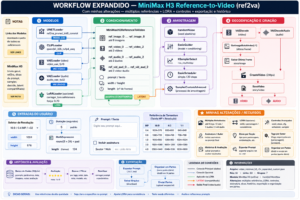
A nova versão amplia a estrutura para 62 nós utilizando apenas recursos nativos. As melhorias incluem interruptores para gerenciar referências, extração automática de frames para sequências narrativas e interface em português. O sistema facilita a criação de vídeos contínuos com alta consistência visual e sonora entre diferentes clipes.
O MiniMax H3 chegou em 3 de agosto de 2026 com suporte nativo ao ComfyUI no mesmo dia — PR #15224, zero drama, funciona. É um modelo de geração omni-modal: você bota texto, imagem, vídeo e áudio como entrada e ele devolve vídeo com áudio estéreo nativo — voz, trilha e efeitos sonoros gerados num único passo de difusão. Não é pós-processado. Não é colado depois. É nativo.
33 bilhões de parâmetros. Vídeos até 2K, 24fps, ~15 segundos. 11 idiomas. Motor Qwen3-VL-32B. Disponível como open weights. Impressionante? Sim. O workflow oficial? Funcional, mas básico demais pra mim.
O Problema com o Workflow Original
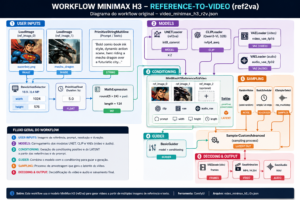
O arquivo oficial da Comfy-Org — video_minimax_h3_r2v.json — vem com 23 nós e suporte a exatamente 2 imagens de referência conectadas diretamente. Sem switch, sem controle, sem como ligar/desligar individualmente sem ficar desconectando fio na mão como um selvagem.
O nó MiniMaxH3ReferenceToVideo suporta até 9 imagens, 3 vídeos e 6 tracks de áudio de referência. O workflow oficial usava 2. Parecia desperdício criminoso.
Então fiz o que qualquer pessoa razoável faria: passei horas refatorando tudo. Em cinco etapas. Com documentação. Porque aparentemente é isso que a gente chama de “hobby”.
O Que Mudou — Tabela Comparativa
| Original | Expandido | |
|---|---|---|
| Nós | 23 | 62 (+39) |
| Links | 25 | 63 (+38) |
| Grupos | 5 | 7 (+2) |
| Imagens de referência | 2 ativas | 9 slots (2 ON, 7 OFF) |
| Vídeos de referência | 0 | 3 slots (todos OFF) |
| Áudios de referência | 0 | 6 slots (todos OFF) |
| Switches Liga/Desliga | 0 | 18 (2 ON + 16 OFF) |
| Modo Sequência | não existia | implementado |
| Extração do último frame | não existia | automática |
| Output vídeo | video/MiniMax_H3 | story/video |
| Output imagem | não existia | story/image |
| Idioma da interface | Inglês | Português Brasileiro |
| Plugins externos | 0 | 0 (100% ComfyUI core) |
Tudo isso sem um único custom node. 100% ComfyUI core. Orgulho de pai.
Switches Liga/Desliga: Controle de Verdade
A ideia é simples: cada slot de referência ganhou um par de nós.
LoadImage / LoadAudio → Switch (PassThrough) → slot de referênciaO switch usa o bypass nativo do ComfyUI:
mode = 0→ nó ativo, dado flui → LIGADOmode = 4→ nó em bypass, dado bloqueado → DESLIGADO
Pra ativar ou desativar: clique direito no nó Switch → “Bypass”. O link continua lá, o workflow continua conectado. Você não fica arrancando fio como se fosse 2019.
Por padrão, os dois primeiros slots de imagem estão ligados — como no workflow original. Os outros 16 slots estão desligados, esperando você precisar deles.
Extração Automática do Último Frame
Pra encadear clipes, você precisa do frame final do vídeo anterior. Antes isso era manual — exporta, abre, salva, carrega de novo, torce pra não errar o frame. Agora é automático.
O nó GetImageBatchIndex com index = -1 (convenção Python: último elemento) extrai o frame final direto da saída do VAEDecode. Conecta no SaveImage e pronto: a cada geração, o workflow salva:
- O vídeo completo em:
ComfyUI/output/story/video/ - O último frame em:
ComfyUI/output/story/image/
Sem plugin VHS. Sem nó externo. Nativo.
Modo SEQUÊNCIA: A Funcionalidade Principal
Essa é a parte que justifica a refatoração inteira. O Modo SEQUÊNCIA permite gerar narrativas longas encadeando clipes — cada um começa exatamente onde o anterior terminou, preservando personagem, iluminação, paleta de cores, câmera e ambiente.
Quando ativado, ele prefixa automaticamente um cabeçalho de instrução no prompt:
“MODO SEQUÊNCIA — Continue exatamente a partir do último frame da referência <Picture 1>. Preserve: identidade do personagem, figurino, direção de iluminação, gradação de cor, ângulo de câmera, ambiente de fundo e atmosfera. NÃO introduza novos personagens, locais ou mudanças de estilo.”
Três nós envolvidos:
- PrimitiveStringMultiline “Cabeçalho SEQUÊNCIA” — contém o texto de instrução, silenciado por padrão (Ctrl+M pra ativar)
- StringConcatenate “Montador de Prompt” — concatena o cabeçalho com o seu prompt base
- MarkdownNote — card de instruções pra você não esquecer como funciona daqui a três semanas
Por que mute e não bypass? Porque PrimitiveStringMultiline não tem inputs. Em bypass, o ComfyUI retorna o próprio valor do widget como output mesmo assim — o cabeçalho seria injetado independente do estado. O mute (mode=2) suprime a execução completamente, produzindo string vazia. O StringConcatenate recebe "" e o resultado é só o prompt base. Comportamento correto. Detalhe que parece pequeno mas que faria a feature não funcionar se eu tivesse usado bypass.
Fluxo de Uso Recomendado
- Gere o primeiro clipe com SEQUÊNCIA silenciada (modo normal)
- O SaveImage salva automaticamente o último frame em
story/image/ - Carregue esse frame no slot “Imagem Ref N” desejado
- Edite o cabeçalho pra referenciar a tag
<Picture N>correta - Ative o Cabeçalho SEQUÊNCIA (Ctrl+M pra remover o mute)
- Gere o próximo clipe — ele continua do frame anterior
- Repita os passos 2–6 quantas vezes precisar
- Junte os clipes
story/video/*no editor de vídeo de sua escolha
Interface em Português Brasileiro
Todos os títulos de nós, grupos e cards de documentação foram traduzidos. Os 44 nós com título, os 7 grupos, 4 cards MarkdownNote — tudo em PT-BR. O único texto mantido em inglês é o prompt de exemplo dentro do nó de entrada, porque o MiniMax H3 processa prompts em inglês com maior fidelidade. Você vai substituir pelo seu prompt de qualquer forma.
Não é só estética: quando você volta pro workflow depois de duas semanas, saber que aquele nó roxo se chama “Montador de Prompt” em vez de “Prompt Assembler (SEQ + Base)” faz diferença na hora de lembrar o que cada coisa faz.
Os Modelos que Você Vai Precisar Baixar
Todos disponíveis no repositório Comfy-Org/MiniMax-H3 no HuggingFace:
| Arquivo | Tamanho | Pasta |
|---|---|---|
minimax_h3_ref2va_pruned_int8_convrot.safetensors |
19,5 GB | models/diffusion_models/ |
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors |
14,6 GB | models/text_encoders/ |
minimax_h3_video_vae_fp16.safetensors |
4,9 GB | models/vae/ |
minimax_h3_audio_vae_fp32.safetensors |
0,6 GB | models/vae/ |
Sim, são quase 40GB. Não, não tem como reduzir muito mais sem comprometer o modelo. Bem-vindo ao mundo dos modelos de vídeo com áudio nativo.
Conclusão
No fim das contas, o workflow expandido saiu de 23 nós pra 62, ganhou controle real sobre todas as entradas de referência, extração automática de frames, modo de encadeamento de clipes, interface em PT-BR e organização visual por zonas — tudo sem um único plugin externo.
Vale o trabalho? Se você vai usar o MiniMax H3 de forma séria pra gerar narrativas com múltiplos clipes, sim, com certeza. Se você só quer testar o modelo e ver o que ele faz — o workflow original de 23 nós resolve. Começa por lá.
Já testou o MiniMax H3? Tentou encadear clipes na mão sem o modo sequência e quis jogar o computador pela janela? Conta nos comentários. E se quiser um post detalhando só os prompts ref2va com exemplos de tag <Picture N>, me fala — tenho material de sobra.
